
TL;DRWarum KI zuerst Ihr Firmenwissen braucht
- Problem
- Ein Chatbot hat nur sein Trainingswissen und sieht Ihre aktuellen Unterlagen und Auftragsdaten nicht. Deshalb nennt er alte Stände, erfindet Zahlen oder zeigt Vertrauliches.
- Lösung
- RAG. Die KI rät nicht, sondern schlägt zuerst im Firmenarchiv nach. Sie zeigt nur, was der Fragende sehen darf, und nennt die Quelle.
- Wichtig
- Alle Unterlagen auf einmal in die KI zu laden, ist langsam und ungenau.
- Jeder sieht nur seinen Bereich.
- Sie müssen vorher nicht aufräumen.
- Vorgehen
- Wissensquellen auflisten, Zugriffsrechte festlegen, Wissensbasis aufbauen, Assistenten bereitstellen. Erst danach bekommt die KI eigene Aufgaben.
- Fazit
- Erst mit RAG wird Ihr Firmenwissen für die KI nutzbar, sicher und prüfbar.
In deutschen Industrie- und Dienstleistungsunternehmen beginnen KI-Initiativen heute fast ausnahmslos auf dieselbe Weise: Ein interner Chatbot wird aufgesetzt, erste Pilotanwender testen die Oberfläche, das Management ist von der Sprachgewandtheit beeindruckt – und die Erwartung an unmittelbare Produktivitätssprünge wächst.
Doch sobald das System im operativen Alltag der Fachbereiche – von der Arbeitsvorbereitung über die Qualitätssicherung bis zum technischen Vertrieb – unter realer Last eingesetzt wird, kippt die Begeisterung. Die Antworten erweisen sich als instabil, technische Spezifikationen widersprechen den tatsächlichen Werkstandards, veraltete Revisionsstände werden zitiert und bei betriebswirtschaftlichen Kennzahlen beginnt das Sprachmodell zu halluzinieren.
Die Ursache liegt selten am gewählten Sprachmodell (LLM). Ob modernste Open-Source-Modelle wie Qwen 3.8 und DeepSeek-V4-Pro oder Hyperscaler-APIs: Die Algorithmen können hervorragend schlussfolgern und formulieren. Das Problem ist fundamentaler Natur: Dem System fehlt ein verlässliches, rollenkonformes Unternehmensgedächtnis.
Ohne eine architektonisch saubere Wissensschicht auf Basis von Retrieval-Augmented Generation (RAG) bleibt jede KI-Initiative ein isoliertes Demo-Werkzeug. Wer Künstliche Intelligenz produktiv und rechtssicher in Kernprozesse integrieren will, muss RAG nicht als nettes Feature, sondern als das tragende Fundament der gesamten IT-Architektur begreifen.
Warum isolierte KI ohne Unternehmensgedächtnis scheitert
In der industriellen Praxis deutscher Unternehmen scheitert Digitalisierung fast nie am Fehlen von Daten. Im Gegenteil: Über Jahrzehnte hinweg haben sich gewaltige Wissensbestände angesammelt. Die Hürde liegt in ihrer extremen Fragmentierung:
- Technische Dokumentation & QM: Arbeitsanweisungen (SOPs), Prüfpläne, ISO-9001-Handbücher und Verfahrensrichtlinien liegen auf Nextcloud, SharePoint oder lokalen Netzlaufwerken (oft als historisch gewachsene PDFs).
- Operative Auftrags- & Fertigungsdaten: Maschinenparameter, Werkzeugdaten, Stücklisten und Fertigungszeiten werden in spezialisierten Branchen-ERPs wie IKoffice (Standard im deutschen Werkzeug-, Formenbau und der Stanztechnik) oder SAP verwaltet.
- Kaufmännische Prozesse: Angebote, Liefertermine, Einkaufskonditionen und Margen befinden sich in Microsoft Dynamics 365 Business Central oder älteren Navision-Umgebungen.
Wird ein modernes Sprachmodell unvorbereitet an solche heterogenen Silos angebunden, treten unvermeidbare Fehlerbilder auf:
- Widersprüchliche Aussagen bei Revisionsständen: Liegen in Nextcloud Version 1.2 und Version 2.0 einer Zeichnungsrichtlinie nebeneinander, wählt das Modell nach statistischer Wahrscheinlichkeit – nicht nach autorisierter Gültigkeit.
- Ignorieren des Geschäftskontexts: Das Modell versteht nicht, welcher Kunde welche Sonderfreigaben besitzt oder welche Werkzeugtoleranzen in IKoffice für ein spezifisches Spritzgusswerkzeug hinterlegt sind.
- Halluzinationen bei Detailfragen: Fehlt die exakte Passage im Modellgedächtnis, erfindet es Drehmomente, DIN-Normen oder Materialzusammensetzungen mit überzeugender Eloquenz.
- Schwere Compliance- und Berechtigungsverletzungen: Ein ungefilterter Assistent liefert dem Auszubildenden vertrauliche Kalkulationssätze oder dem Vertrieb sensible Personalnotizen.
Ein reines Sprachmodell besitzt kein inhärentes Wissen über Ihre Firmenstandards. Es gleicht einem brillanten neuen Mitarbeiter am ersten Arbeitstag: hochgradig sprachgewandt, aber ohne Orientierung im Betrieb. RAG gibt diesem Mitarbeiter das autorisierte, tagesaktuelle Handbuch an die Hand – und zwar punktgenau für die jeweilige Aufgabe.
Was RAG in einer modernen Enterprise-Architektur bedeutet
Retrieval-Augmented Generation (RAG) bezeichnet eine zweistufige Architektur, die Sprachgenerierung und Faktenabruf strikt voneinander entkoppelt:
- Das Sprachmodell (LLM) ist ausschließlich für Verständnis, Synthese und Formulierung zuständig.
- Die RAG-Infrastruktur ist für die Bereitstellung geprüfter, autorisierter Fakten in Echtzeit zuständig.
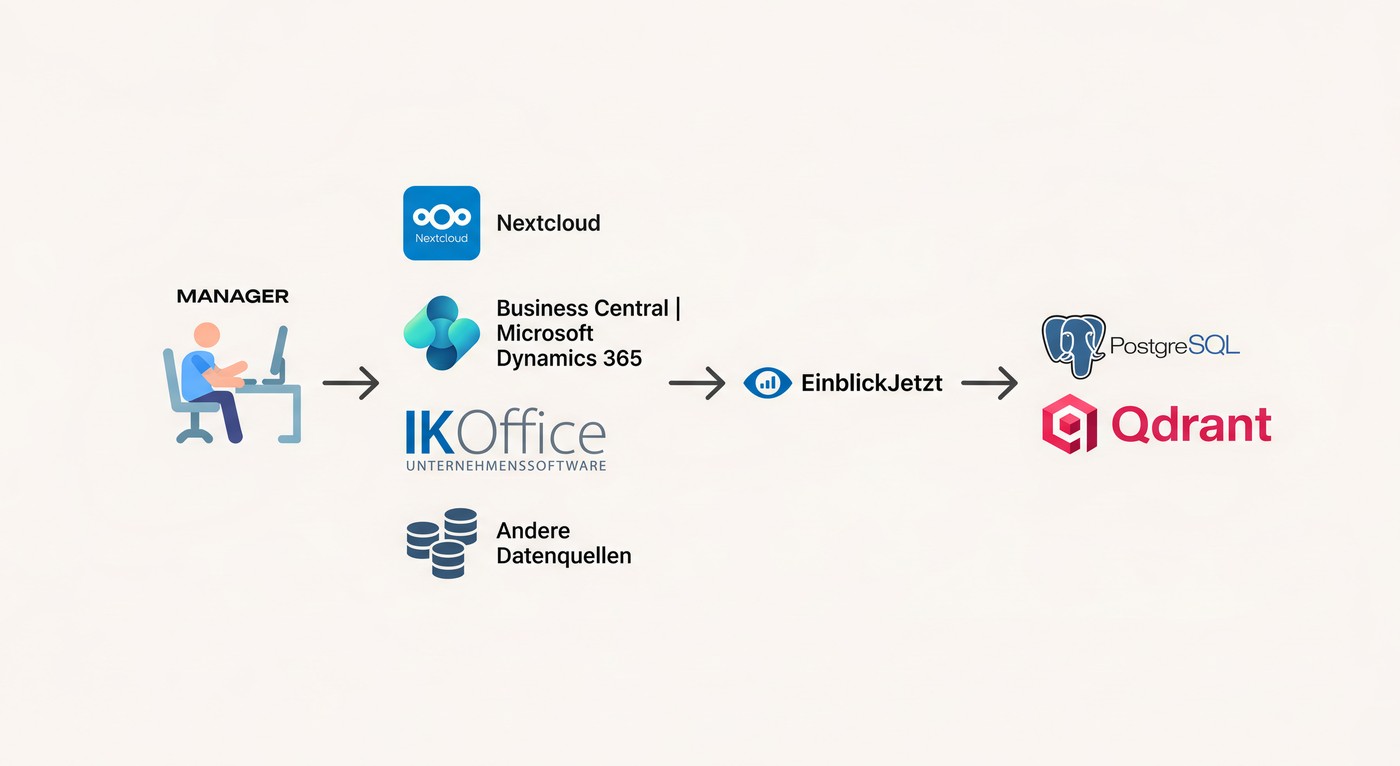
Der operative Ablauf einer Anfrage vollzieht sich in vier kontrollierten Phasen:
- Kontextsuche (Retrieval): Stellt ein Anwender eine fachliche Frage, durchsucht das RAG-System die Unternehmensdatenbanken nach den semantisch und relational passendsten Passagen.
- Rechtefilterung: Das System prüft die Rolle und Freigabestufe des Nutzers (z. B. via Active Directory oder Nextcloud-Rollen) und entfernt nicht autorisierte Chunks.
- Prompt-Erweiterung (Augmentation): Die berechtigten Originalfragmente werden zusammen mit der Nutzeranfrage in einen geschützten Systemkontext eingebettet („Beantworte die Frage ausschließlich auf Basis der folgenden Dokumentenabschnitte. Gib zu jeder Aussage die exakte Quelle an“).
- Faktengebundene Antwort (Generation): Das LLM formuliert die Antwort präzise, nachvollziehbar und transparent mit direktem Quellverweis auf das Ursprungsdokument.
4 Aha-Momente für Entscheider und IT-Leiter
Viele KI-Diskussionen im deutschen Mittelstand bleiben an der Oberfläche oder verfangen sich in Marketing-Schlagworten. Um fundierte architektonische Entscheidungen zu treffen, sind vier tiefere Einsichten entscheidend:
1. Der „Kontextfenster-Trugschluss“: Warum 1–2 Millionen Tokens RAG nicht ersetzen
Mit dem Aufkommen von Modellen, die Millionen Tokens im Kontextfenster verarbeiten können, hört man in Führungsetagen häufig die Frage: „Warum brauchen wir überhaupt eine RAG-Datenbank? Können wir nicht einfach alle Handbücher und ERP-Exporte direkt in den Chat werfen?“
In der Praxis scheitert dieser Ansatz an drei harten Kriterien:
- Der „Lost in the Middle“-Effekt: Empirische Forschungen zeigen, dass LLMs Informationen am Anfang und am Ende eines Megaprompts zuverlässig erfassen, Details in der Mitte eines 500-Seiten-Kontexts jedoch regelmäßig übersehen oder falsch zuordnen.
- Latenz und Wirtschaftlichkeit: Einen Prompt mit 500.000 Tokens zu verarbeiten, dauert 20 bis 40 Sekunden und verursacht pro Abfrage erhebliche Kosten. Ein gezielter RAG-Abruf extrahiert die relevanten 3 Absätze in unter 150 Millisekunden.
- Fehlende Zugriffsgrenzen: Ein Context Window ist ein monolithischer Speicher. Einmal übergeben, hat das Modell Zugriff auf jedes Wort. Eine dynamische Filterung nach Abteilung, Mandant oder Sicherheitsstufe ist im Prompt technisch unmöglich.
RAG fungiert als intelligenter Gatekeeper: Es sorgt dafür, dass nur das im Arbeitsgedächtnis des Modells landet, was für die konkrete Aufgabe zwingend erforderlich und für den Nutzer freigegeben ist.
2. Hybrides RAG: Warum reine Vektorsuche an ERP-Tabellen scheitert
Vektordatenbanken wandeln Texte in hochdimensionale mathematische Einbettungen (Embeddings) um. Über Ähnlichkeitsmaße wie die Cosine Similarity finden sie Bedeutungszusammenhänge hervorragend: Eine Suche nach „Wartungsintervall Spindel“ findet auch Abschnitte über „Inspektion der Frässpindel alle 500 Betriebsstunden“.
Doch bei tabellarischen, relationalen Daten versagt reine Vektorsuche vollständig:
Beispielfrage: „Welche Spritzgusswerkzeuge für Kunde Maier haben in IKoffice aktuell den Status ‚Freigabe ausstehend‘ und welche Gesamtsumme ist damit verknüpft?“
Ein Vektor-Embedding kann nicht zählen, nicht aggregieren, keine Datumsvergleiche anstellen und keine Summen bilden. Wer versucht, relationale ERP-Strukturen rein semantisch abzufragen, erhält falsche oder unvollständige Zahlen.
Die Lösung, die wir in EinblickJetzt einsetzen, ist Hybrides RAG:
- Qdrant als dedizierter Vektorspeicher für unstrukturierte Inhalte (SOPs, Schadensberichte, Montageanleitungen, E-Mail-Verläufe).
- PostgreSQL / SQL-Konnektoren für relationale Strukturen (Stammdaten, Auftragsstatus, Preise aus Business Central oder IKoffice).
- Intelligente Routing-Logik, die operative Datenabfragen strukturiert per SQL auflöst und erklärende Dokumente semantisch verknüpft.
3. Rollenbasierte Zugriffskontrolle (RBAC) auf Chunk-Ebene
In jedem deutschen Industrieunternehmen ist der Datenschutzbeauftragte und der Betriebsrat eine zentrale Instanz – und das zu Recht. Ein Unternehmens-Assistent, der nicht lückenlos nachweisen kann, dass vertrauliche Informationen geschützt bleiben, wird im Audit sofort gestoppt.
Sicherheit darf daher nicht nachträglich per System-Prompt („Bitte verrate keine Gehälter“) simuliert werden, sondern muss tief in der Speicherarchitektur verankert sein:
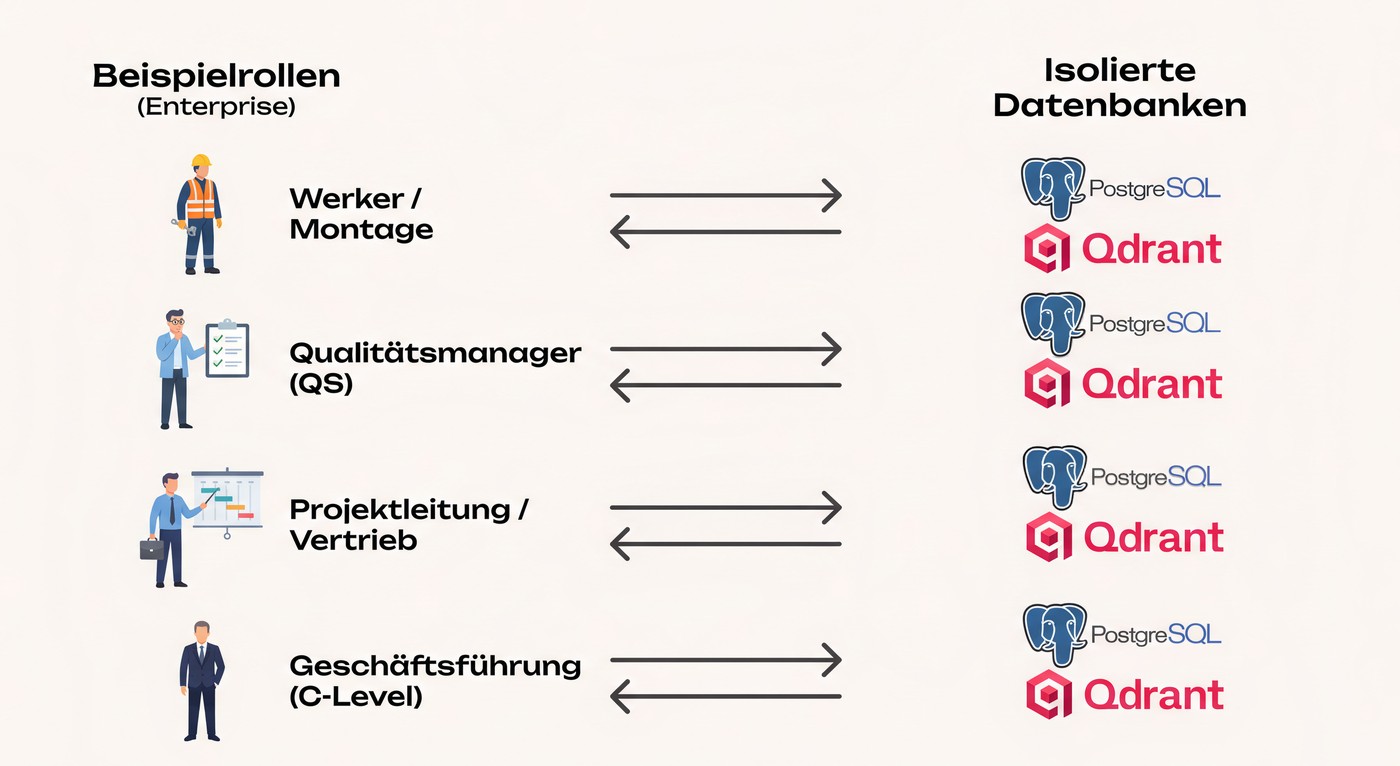
In einer sauberen RAG-Architektur wird jedes Dokumentenfragment beim Einlesen mit Metadaten indiziert:
user_role&security_clearancedepartment(z. B. QS, Fertigung, HR, C-Level)system_source(z. B. Nextcloud, IKoffice, Business Central)validity_date&revision_state
Stellt ein Fertigungsmitarbeiter eine Frage in Nextcloud Talk, schließt der Retriever alle Chunks aus, die als vertraulich markiert sind. Das LLM erfährt zu keinem Zeitpunkt, dass andere Dokumente überhaupt existieren.
4. Datenaufbereitung ohne „Frühjahrsputz-Falle“
Ein weit verbreiteter Irrglaube lautet: „Wir müssen erst über zwei Jahre hinweg all unsere Netzlaufwerke aufräumen, bevor wir über KI nachdenken können.“
Das Gegenteil ist der Fall. Niemand hat im operativen Tagesgeschäft Zeit für manuelle Datenbereinigungen. Eine moderne Ingestion-Pipeline übernimmt diese Arbeit automatisiert:
- Sie extrahiert Text, Tabellen und Metadaten aus komplexen, verschachtelten PDFs (siehe auch unseren Beitrag zur PDF-Verarbeitung in Unternehmen).
- Sie bereinigt Duplikate und verknüpft Revisionsstände.
- Sie strukturiert unorganisierte Wissensberge durch intelligentes semantisches Chunking nach Überschriftenhierarchien.
Die Praxis im Vergleich: Bastellösungen vs. Enterprise-Infrastruktur
Viele Unternehmen experimentieren zu Beginn mit No-Code-Tools wie n8n oder generischen SaaS-Chatbots. Was für einfache Webhooks im Marketing taugt, stößt bei industriellen Kernprozessen schnell an unüberwindbare Hürden:
| Anforderung | No-Code-Bastellösung (z. B. n8n / Make) | Enterprise RAG-Infrastruktur (EinblickJetzt) |
|---|---|---|
| Datenanbindung | Lineare Webhooks, instabil bei großen Dokumentenmengen | Native Konnektoren für Business Central, IKoffice, Nextcloud, SAP |
| Sucharchitektur | Meist nur einfache Keyword- oder naive Vektorsuche | Hybrides RAG: Qdrant (Vektoren) + PostgreSQL (Relationen & Logs) + Re-Ranking |
| Datenschutz & Souveränität | Häufig US-Cloud-Abhängigkeit, unklare Datenflüsse | 100 % DSGVO-konform, Hosting in Deutschland oder On-Premise |
| Zugriffsrechte (RBAC) | Kaum granulare Rechtefilterung auf Fragmentebene | Striktes Chunk-Level-Filtering gespiegelt aus Active Directory / Nextcloud |
| Modellauswahl | Meist fest an einen Anbieter gekoppelt (Vendor-Lock-In) | Modellunabhängig (Open-Source wie Qwen/DeepSeek oder private Cloud-Modelle) |
| Frontend-Integration | Meist eigene isolierte Web-Widgets | Nahtlos in Nextcloud Talk, Microsoft Teams oder Custom Web-Portal |
Praxis-Transfer: Was High-Stakes-Projekte bei Carl Zeiss und Trench Group beweisen
Die Notwendigkeit sauberer, dekomponierter Datenarchitekturen ist kein theoretisches Konstrukt. Sie entscheidet in Großkonzernen wie im gehobenen Mittelstand über Erfolg oder Stillstand digitaler Wertschöpfung. Zwei Referenzbeispiele aus unserer Beratungspraxis verdeutlichen diese Prinzipien:
Carl Zeiss AG: Skalierbare Datenarchitektur für Präzisionsumgebungen
Bei der Carl Zeiss AG stand das bisherige Berichtswesen im modernen Fertigungsumfeld vor massiven Herausforderungen: Gewachsene On-Premise-Monolithen, zeitraubende Datenverarbeitung aus Kafka-Events und unübersichtliche Datenstrukturen bremsten Analysen aus.
Innovaforge dekomponierte die Gesamtarchitektur und überführte sie in eine zukunftsfähige, Cloud-native Lösung auf Basis von Databricks, PySpark und Delta Tables.
Der Transfer zu RAG: Genau wie Fertigungsberichte bei Zeiss nur dann verlässlich sind, wenn Pipelines Daten in Echtzeit transformieren und bereinigen (Verkürzung der Verarbeitungszeit um 80 %), benötigt auch ein RAG-System deterministische, fehlertolerante Datenströme. Wer historische Wissensbestände mit tagesaktuellen Fertigungsinformationen verknüpfen will, braucht saubere Schichten und strikte Datenmodelle.
(Details in unserer Fallstudie: Carl Zeiss: Cloud-Migration des bestehenden Berichtssystems)
Trench Group GmbH: Globale Datenplattform, Souveränität & Agentic AI
Für die Trench Group GmbH – einen weltweit führenden Konzern in der Hochspannungstechnik (> 1,1 Mrd. USD Umsatz, 11 Werke auf vier Kontinenten) – konzipierte und implementierte Innovaforge eine mandantenfähige Azure Data Platform über fünf globale Regionen. Unter Einhaltung strengster Datenresidenz-Vorgaben (DSGVO, USMCA) wurde eine Medallion-Architektur aufgebaut und durch maßgeschneiderte Agentic AI mit gehosteten Model Context Protocol (MCP) Servern ergänzt.
Der Transfer zu RAG: In verteilten Konzernstrukturen ist RAG kein lokales Spielzeug, sondern ein globales Koordinationswerkzeug. Technische Spezifikationen für Hochspannungstransformatoren, internationale Prüfprotokolle und SAP-Daten müssen über Werksgrenzen hinweg auffindbar sein – ohne dass geschützte Konstruktionsdaten die vorgegebenen Compliance-Grenzen überschreiten.
(Details in unserer Fallstudie: Trench Group: Globale Azure Data Platform mit Medallion-Architektur und Agentic AI)
EinblickJetzt: Die souveräne Enterprise-Wissensplattform
Aus den Erfahrungen anspruchsvoller Industrieprojekte haben wir EinblickJetzt entwickelt – die RAG- und KI-Plattform von Innovaforge für den deutschen Mittelstand.
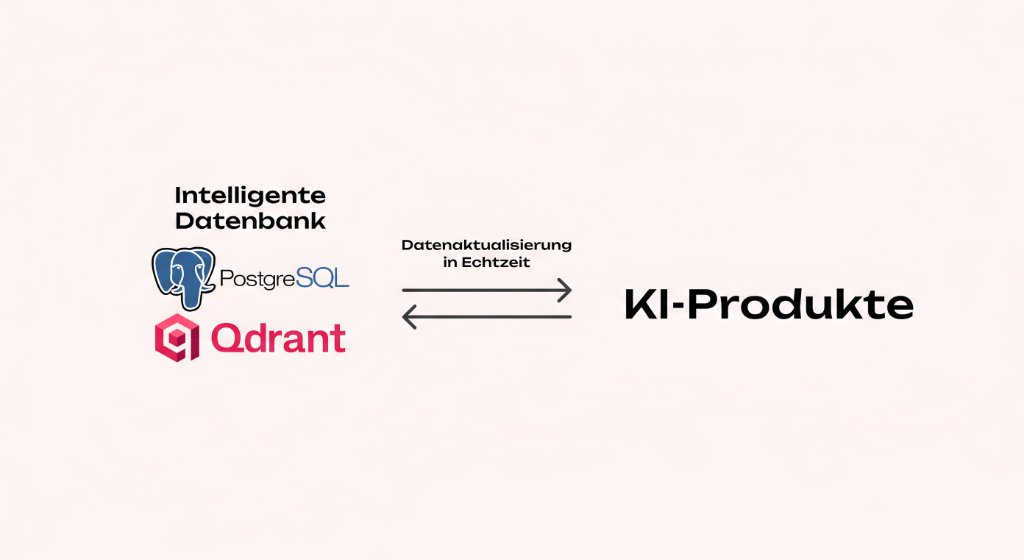
EinblickJetzt löst das Unternehmensgedächtnis ganzheitlich:
- OpenWebUI Pipelines & Workflow-Automatisierung: Statt simpler Frage-Antwort-Fenster werden Workflows orchestriert – inklusive Plausibilitätsprüfungen und direkter Rückführung in bestehende Fachanwendungen.
- Souveräne IT-Infrastruktur: Bereitstellung wahlweise On-Premise auf kundeneigener Hardware oder auf dedizierten GPU-Kapazitäten in zertifizierten deutschen Rechenzentren. Ihre Daten verlassen zu keinem Zeitpunkt den europäischen Rechtsraum.
- Kein Vendor-Lock-In: Unterstützung modernster Open-Source-Modelle (wie Qwen, DeepSeek oder Nvidia Nemotron) mit spezifischem Fine-Tuning auf die Fachsprache Ihres Unternehmens.
- Echte DACH-Integration: Vorgefertigte Anbindungen an Microsoft Dynamics 365 Business Central, IKoffice, Nextcloud, SAP und SharePoint. Mitarbeiter interagieren direkt in ihrer gewohnten Kommunikationsumgebung (Nextcloud Talk oder Microsoft Teams).
Was sich auf einer stabilen RAG-Basis aufbauen lässt
Sobald das Unternehmensgedächtnis verlässlich verankert ist, wird KI von einer experimentellen Spielerei zur skalierbaren Plattform für das gesamte Unternehmen:
- Digitaler Assistent für Arbeitsvorbereitung & Fertigung: Werker rufen per Tablet oder Nextcloud Talk sofort die passende Rüstvorschrift, Drehmomentangabe oder Fehlerbehebung aus Nextcloud und IKoffice ab.
- Technischer Vertriebs-Copilot: Vertriebsmitarbeiter erhalten in Sekunden präzise Auskunft darüber, ob eine spezifische Kundenanforderung mit den vorhandenen Werkzeugen machbar ist und welche Lieferzeiten in Business Central hinterlegt sind.
- Automatisiertes Qualitäts- & Reklamationsmanagement: Bei einer Kundenreklamation gleicht das System die Fehlerbeschreibung automatisch mit historischen Prüfberichten und FMEA-Dokumenten ab und schlägt Korrekturmaßnahmen vor.
- Beschleunigtes Onboarding von Fachkräften: Neue Mitarbeiter finden sich in hochkomplexen internen Prozesswelten sofort zurecht, ohne erfahrene Kollegen bei Routinefragen binden zu müssen.
Der Stufenplan zum eigenen Unternehmensgedächtnis
Ein nachhaltiges RAG-Projekt beginnt nicht mit der Auswahl des Sprachmodells, sondern mit der Systematik der Daten:
- Inventur der Wissens- und Datenquellen: Erfassen der führenden Systeme (z. B. Nextcloud für Dokumente, IKoffice für Fertigungsdaten, Business Central für kaufmännische Parameter).
- Definition des Rollen- und Compliance-Modells: Abstimmung der Zugriffsebenen mit Fachbereichen, Datenschutzbeauftragten und Betriebsrat.
- Aufbau der hybriden RAG-Schicht: Implementierung der EinblickJetzt-Ingestion mit Qdrant (Vektoren) und PostgreSQL (Relationen/Metadaten) inklusive automatisierter Synchronisation.
- Bereitstellung in den Arbeitswerkzeugen: Rollout des Assistenten in Nextcloud Talk, Teams oder browserbasierten Fachbereichs-Dashboards.
- Erweiterung um autonome Agenten: Nach erfolgreicher Etablierung der Wissensbasis können spezialisierte KI-Agenten operative Teilaufgaben (z. B. automatische Entwurfserstellung von Prüfberichten) selbstständig übernehmen.
Fazit: Erst das Fundament, dann die Automatisierung
Die Mehrheit der KI-Projekte scheitert heute nicht an der Leistungsfähigkeit moderner Sprachmodelle, sondern am Fehlen einer verlässlichen Wissensbasis. Ein Sprachmodell ohne RAG ist im Unternehmensalltag blind für betriebliche Realitäten.
Eine durchdachte RAG-Infrastruktur verwandelt unstrukturierte und fragmentierte Wissensbestände in ein kontrollierbares, auditierbares und DSGVO-konformes Unternehmensgedächtnis. Erst auf diesem Fundament können KI-Assistenten und Agenten ihre transformative Wirkung entfalten – sicher, skalierbar und wirtschaftlich rentabel.
Möchten Sie erfahren, wie Sie die Wissensschätze in Ihren Systemen – von Nextcloud über Business Central bis IKoffice – sicher für KI nutzbar machen? Entdecken Sie unser Leistungsangebot in der AI Beratung, informieren Sie sich über moderne Data Warehouse Architekturen oder kontaktieren Sie uns direkt für ein unverbindliches Architekturgespräch.
FAQ
Warum scheitern isolierte KI-Chatbots in deutschen Unternehmen oft ohne RAG?
Ohne eine einheitliche Wissensschicht greift das Sprachmodell ausschließlich auf sein statisches Trainingswissen zurück. Es kennt weder die neueste Revision der internen Arbeitsanweisungen (SOPs) noch operative ERP-Daten aus Microsoft Dynamics 365 Business Central oder IKoffice. Dies führt zu Halluzinationen, veralteten Aussagen und gravierenden Compliance-Risiken.
Reicht ein großes Kontextfenster (1–2 Mio. Tokens) moderner LLMs nicht aus, um RAG zu ersetzen?
Nein. Riesige Prompts leiden unter dem 'Lost in the Middle'-Effekt, bei dem relevante Details in der Textmasse übersehen werden. Zudem explodieren Token-Kosten und Antwortlatenzen. Entscheidend ist vor allem die Governance: Ein Prompt-Kontext bietet keine rollenbasierte Zugriffskontrolle (RBAC) auf Datenbankebene. RAG filtert Berechtigungen strikt vor der Modellanfrage.
Warum versagt reine Vektorsuche bei strukturierten ERP- und Fertigungsdaten?
Vektordatenbanken ermitteln semantische Textähnlichkeiten (Cosine Similarity), können jedoch keine exakten Aggregationen, Zählungen oder Datumsfilter durchführen. Operative Fragen wie 'Welche Bauteile sind in IKoffice aktuell in Verzug?' erfordern Hybrides RAG, das Vektorspeicher (Qdrant) mit relationalen Datenbanken (PostgreSQL) und direkten ERP-Schnittstellen verbindet.
Wie garantiert die EinblickJetzt-Architektur Datenschutz und Rollenrechte (RBAC)?
Dokumentenabschnitte (Chunks) werden bereits bei der automatisierten Ingestion mit Berechtigungs- und Klassifizierungs-Metadaten versehen. Das System spiegelt Benutzerrechte (z. B. aus Active Directory, Nextcloud oder Microsoft Entra ID) wider, sodass Mitarbeiter in Nextcloud Talk oder Teams ausschließlich Informationen erhalten, für die sie autorisiert sind.
Welche Systeme bindet EinblickJetzt im Standard an?
EinblickJetzt integriert führende Enterprise-Systeme des DACH-Raums – darunter Microsoft Dynamics 365 Business Central, IKoffice, SAP, Nextcloud, SharePoint sowie Netzlaufwerke – und stellt verifiziertes Wissen in Nextcloud Talk, Microsoft Teams oder browserbasierten Fachportalen bereit.